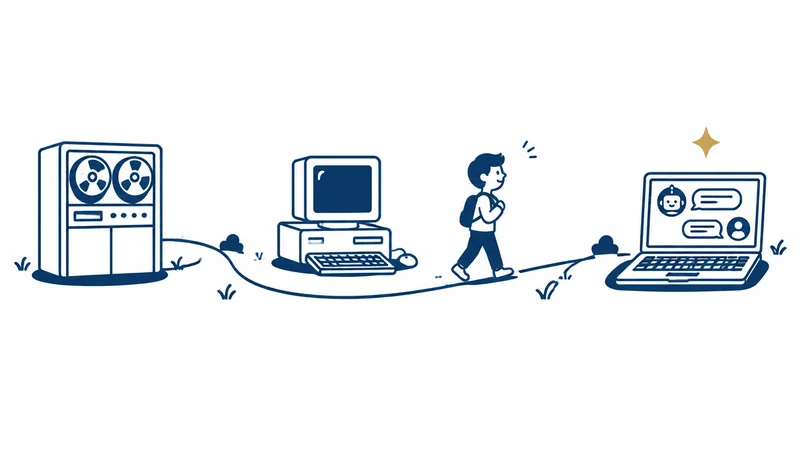
AIは、最近できた言葉ではありません。70年かけて少しずつ育ちました。急に伸びたのは、最後の10年ほどです。
この記事の結論
- AIは新しい発明ではありません。70年かけて少しずつ育ちました。急に伸びたのは、最後の10年ほどです。
- いまのAIの中身は「次に来る言葉を、いちばんありそうな順に選ぶ」機械です。意味が分かって答えているのではありません。
- 脳のしくみをヒントに作り、大きくしたら、正しい答えが出るようになりました。ただ、なぜうまく動くのかは、作った人たちにもまだよく分かっていません。
- だから、それらしい間違いが混じります。使う人の仕事は「確かめること」。ここは機械に渡せません。
AIという言葉は、70年前に生まれました
文部科学省の白書によると、「AI」という言葉は1955年に生まれました。つくったのは、米国の研究者ジョン・マッカーシーです。翌1956年のダートマス会議で、研究として始まりました。
日本が高度成長に入る前の話です。当時のAIは、いまのものとまったく違います。
やり方は「推論と探索」と呼ばれました。推論は、分かっていることから答えを組み立てること。探索は、考えられる手を順番に全部試して、当たりを探すことです。
迷路の出口を、分かれ道を全部歩いて探すのと同じです。手順は人間が書きます。機械は、書かれたとおりに探すだけです。
これで解けたのは、パズルや簡単なゲームまででした。現実の仕事は、分かれ道が多すぎます。「段取りを全部書く」やり方では追いつきません。
期待が大きかった分、失望も大きくなりました。研究のお金は止まりました。これを「冬の時代」と呼びます。
二度の冬。「ルールを手で書く」限界
1980年代に、二度目の盛り上がりが来ました。主役は「エキスパートシステム」です。ベテラン社員の判断を「もし〜なら、こうする」という形で書き出し、機械に持たせる仕組みです。
病気の診断や、設備の故障の見分けに使われました。例えるなら、分厚いマニュアルです。よくある場面は書いてあるので、うまく当たれば速い。
しかし現場は例外だらけです。書いていない場面が来ると、機械は黙ります。ルールを足すと、今度はルール同士がぶつかります。
書き足す人の手間も終わりません。ルールが増えるほど、直すのが大変になります。
総務省の白書も、同じように整理しています。当時は学習させるデータ量が膨大で、計算機の性能が足りませんでした。そのため複雑な問題に対処できず、研究は再び冬を迎えました。
ここで分かったことが、次の時代の出発点になりました。「人が手順を書く」のをやめる。かわりに「機械に例を見せて、自分で覚えさせる」。この方向に変わりました。
2012年、機械が写真を見分けた
「例を見せて覚えさせる」やり方を、機械学習と呼びます。求人票の書き方を教わらなくても、良い求人票を100枚見れば型が分かる。あの感覚に近いものです。
転機は2012年でした。世界中の研究者が競う画像認識の大会(ILSVRC2012)がありました。ここでトロント大学のチーム「SuperVision」が優勝します。
公式の結果ページに残っている誤り率は約15.3%です。100枚のうち15枚ほどを間違えた、という意味です。当時としては段違いの成績でした。
このとき使われたのが、深層学習(ディープラーニング)です。脳の神経のつながりをまねた計算を、何層も重ねる方式です。層を重ねるほど、細かい特徴を見分けられます。
大事なのは「なぜ勝てたか」です。猫の特徴を人が書き出したのではありません。大量の写真を見せて、どこに注目すべきかを機械の側に見つけさせました。
人が言葉にできない勘の部分を、機械が数字で握った、ということです。
この日から、AIは研究室の中だけの話ではなくなりました。顔認証、レジの自動化、検品の自動化は、ここから伸びた枝です。
2017年の設計図が、いまのAIをつくった
文章は、写真より厄介です。「それ」「あれ」が何を指すかは、離れた場所を見ないと決まりません。前から順に一語ずつ読む方式では、長い文で迷子になります。
2017年、Google の研究者らが「Attention Is All You Need」という論文を出しました。提案された仕組みが Transformer(トランスフォーマー)です。
論文の要旨には、こう書かれています。順番に読む仕組みも画像向けの仕組みも完全にやめ、注意(attention)だけで組んだ、と。
注意とは、文の中で「いまどこを見るべきか」に重みを置くことです。会議の議事録を読むとき、全部の行を平等に読む人はいません。数字と決定事項に目が飛びます。
あの目の配分を、計算でやります。しかもこの方式なら、文の全体を一度にまとめて見られます。だから、大量の文章を速く学習できるようになりました。
そこに莫大な文章と計算を注ぎ込んだものが、大規模言語モデル(LLM)です。大規模言語モデルとは、言葉の続き方を覚えさせた機械のこと。とてもたくさんの文章を読ませてつくります。
2022年ごろから、一般の人が使えるサービスとして広まりました。2026年9月時点でも、モデルの名前・性能・料金は数か月単位で変わり続けています。名前を覚える価値は、正直あまりありません。
LLM(大規模言語モデル)って、なんですか?
LLMは、英語の Large Language Model の頭文字です。日本語では「大規模言語モデル」。ChatGPT、Gemini、Claude の中身は、どれもこのLLMです。
「大規模」とは、3つのものが大きいという意味です。読ませた文章の量。中にある数字の数。そして、覚えさせるのに使った計算の量です。
中にある数字を、パラメータと呼びます。脳でいえば、神経と神経のつながりの強さにあたる数字です。2020年に発表された GPT-3 は、約1750億個でした。
作り方は、大きく2段階です。
- 1. たくさん読ませるインターネットや本の文章を読ませ、「次に来る言葉当て」を何度も何度も練習させます。ここで、言葉の続き方を覚えます。
- 2. 会話向けに仕上げる人が「この答えは良い」「これはだめ」と教えて、質問に答えやすい形に整えます。これで、話しかけると返事をする道具になります。
2つ目の仕上げが入ったことで、専門家でなくても使えるようになりました。2022年11月に ChatGPT が公開され、一気に広まったのはこのためです。
仕組みは「次に来る言葉を確率で選ぶ」だけ
ここが一番の要点です。文章を書くAIの中身は、意味の理解ではありません。文部科学省の白書は、対話型の生成AIは「統計的に次の言葉を予測しているに過ぎず」と、はっきり書いています。
「統計的に予測する」とは、たくさんの例を数えて、いちばん多かったものを選ぶことです。
たとえで言います。「お世話になって」と来たら、次は「おります」が来る確率が高い。「本日はお足元の」なら「悪い中」。
膨大な文章を読み込んで、この「続きの出やすさ」を細かく覚えた機械です。それを一語ずつ、最後まで続けているだけです。
だから、文章はうまい。丁寧で、形が整っています。そして、ここが怖いところです。内容が空でも、形だけは整ってしまいます。
事実を知らない場合も、「いちばんありそうな続き」を出します。実在しない法律の名前、実在しない商品の名前、それらしい数字。これが「もっともらしい嘘」です。
専門用語では、ハルシネーションと呼びます。もとは「幻を見ること」という意味の言葉です。AIが、ないものをあるように書いてしまう現象を指します。
AIに嘘をつく気はありません。仕組み上、そうなります。空欄を空欄のまま置くのが苦手で、必ず何かで埋める。そういう機械だと思ってください。
なぜうまく動くのか、じつは分かっていない
ここまでの話には、ふしぎな点があります。深層学習は、人間の脳をヒントに作られました。脳の神経細胞がつながり合う形を、計算でまねたものです。
ただし、まねたのは形のおおまかな考え方だけです。本物の脳とは、まったく別物です。
ところが、これを大きくしていくと、正しい答えがどんどん出るようになりました。文法のルールも、歴史の知識も、誰も書き込んでいません。それでも、ちゃんと答えが合うのです。
では、中で何が起きているのか。じつは、作った研究者たちにも、まだよく分かっていません。
中の数字は、全部見ることができます。でも、何千億個もの数字の並びを見ても、人には意味が読めません。料理がおいしいのは分かるのに、レシピが暗号で読めない。そんな状態です。
この「中が見えない」状態を、ブラックボックスと呼びます。LLMを作っている会社の Anthropic も、自社のAIについて、ほぼブラックボックスとして扱ってきたと書いています。
いま、中身を解き明かす研究が進んでいます。2024年には、AIの中で「この数字の組み合わせは、この物事を表している」という対応が、数百万個見つかりました。それでも、全体の説明にはまだ遠い状態です。
考えてみると、人間の脳も同じです。自分がなぜそう思ったのか、全部を説明できる人はいません。
ここから言えることが1つあります。AIに「なぜその答えなの?」と聞いても、返ってくる説明が本当の理由とは限りません。その説明も「ありそうな続き」として作られた文章だからです。
付き合い方は「下書きは任せ、確かめは手放さない」
以上をふまえると、任せる範囲がはっきりします。
- 任せていい仕事文章の下書き、言い換え、長い文の要約、案出し、体裁の整理。元の材料がこちらにあり、間違いを人が見つけられる仕事です。
- 任せてはいけない仕事最後の判断と、事実の確定です。金額・日付・人や会社の名前・法律・自社の数字。ここは必ず人が原本と見比べます。とくに社外に出す文書と、お金が動く書類は例外なしです。
うまい使い方は、白紙をなくすことです。0から100まで任せるのではなく、0を30にしてもらう。30から100は人の仕事です。
この形にすると、AIの弱点が事故になりません。
70年の歴史を一行でまとめると、こうなります。「手順を書く」から「例から覚える」へ。そして、覚えたものは、言葉の続き方でした。
賢い部下ではなく、よく喋る道具として使うのが正解です。
よくある質問
Q. AIは人の頭と同じように考えているのですか。
違います。文章を書くAIの中身は、膨大な文章から覚えた「次に来る言葉の出やすさ」を計算する仕組みです。文部科学省の白書も「統計的に次の言葉を予測しているに過ぎず」と書いています。意味を理解して判断しているわけではありません。ですから、内容の正しさは人が確かめる前提で使ってください。
Q. AIがなぜ動くのか、本当に分かっていないのですか。
作り方は分かっています。脳の神経のつながりをヒントにした計算に、大量の文章を読ませて「次の言葉当て」を練習させます。分かっていないのは、覚えた後の中身です。中にある何千億個もの数字が、それぞれ何を意味しているのかは、作った研究者にもほとんど読めません。この状態をブラックボックスと呼びます。中身を調べる研究は進んでいますが、全体の説明にはまだ遠い状態です。
Q. なぜ堂々と間違えるのですか。
知らないことを、空欄のまま出せない仕組みだからです。「いちばんありそうな続き」を選ぶため、事実がなくても、それらしい形の答えができてしまいます。文章がうまいことと、内容が合っていることは別です。数字・日付・人や会社の名前は、必ず原本と照らし合わせてください。
Q. 最新のAIを選んだほうが得ですか。
2026年9月時点で、モデルの名前や料金は数か月ごとに変わります。追いかける価値は小さめです。それより「どの仕事の下書きに使うか」を1つ決めるほうが効きます。使う仕事が決まっていれば、道具が新しくなっても、乗り換えるだけで済みます。
Q. 自社のデータを勝手に覚えられませんか。
サービスと契約の設定次第です。IPA は利用者向けの注意として「クラウドAIに営業秘密は教えない」を最初に挙げています。まず、無料版に顧客名簿や見積の原価を貼らないこと。仕事で使うなら、始める前に2つ確かめてください。入力した内容が学習に使われない設定か。そして、会社向けの契約かどうかです。
AIが重い理由と、パソコンの性能の話 → AIを使うのに、なぜスペックの高いPCがいいのか
参考
- 総務省「令和6年版 情報通信白書」(AIブームと冬の時代)
- 文部科学省「令和6年版 科学技術・イノベーション白書」第1章
- Vaswani et al.「Attention Is All You Need」(2017)
- Krizhevsky et al.「ImageNet Classification with Deep Convolutional Neural Networks」(2012)
- ImageNet「ILSVRC2012 Results」
- Brown et al.「Language Models are Few-Shot Learners」(2020・GPT-3)
- Ouyang et al.「Training language models to follow instructions with human feedback」(2022)
- Anthropic「Mapping the mind of a large language model」(2024)